每个上过学的人都懂一个道理:错题本比题海有用。做对一百道题,不如把一道错题的错因彻底搞明白——因为错误一经讲解,它磨砺出的判断力远超重复的成功。
2026 年 7 月,复旦大学副校长蒋云岗在世界人工智能大会上公开说:失败数据对模型的重要性不亚于成功数据,基础模型的语料建设就该像错题本。台下共鸣一片。
但共鸣归共鸣,行业实际做了什么?每一次强化学习都在产生失败,每一个验证器都在标记失败——而几乎没有一条失败被当作训练资产留下来。
我们做了一次系统审计,把这个问题变成可以核验的数字。先讲主张,再讲怎么查,最后讲查到了什么。
一、主张:成功给方向,失败给精度
这个主张有精确的版本。用贝叶斯的语言说:一次成功的演示,确认了某个策略可行——它给的是方向;一次被归因的失败,剔除了假设空间中的一块区域——它给的是精度。
方向和精度不是一回事。在同一块区域里堆一百次冗余的成功,后验不会更尖锐;而一次解释清楚的失败,直接把那块区域从搜索空间里划掉。学生刷一百道已经会的题,不如订正一道错题——数学上就是这么回事。
但这个主张自带三个告诫,缺一个它就退化为口号:
- 失败必须多样。 同质的失败等于一道错题抄一百遍——信息量为零,起作用的变量是失败模式的覆盖面,不是任何固定的成功-失败比例。
- 失败必须去毒。 奖励作弊式的”假成功”有主动危害,混进来是污染不是数据。
- 失败必须归因。 没有根因的失败记录,只是”错了”两个字——精度来自”错在哪”。
认知科学里有先例:人从亲历的损失中学到的判断,和从书本描述中学到的判断,系统性不同;损失甚至能先于意识洞察、被身体内隐编码并引导决策。我们不声称这些结果能直接搬给梯度下降——它们是动机,不是证明。
二、为什么现在重要
因为当前前沿模型最弱的两个维度——泛化与校准——恰好都指向训练数据实践,而失败驱动学习正是针对这两个维度的候选信号。
看三条证据链。其一,可验证奖励的强化学习(RLVR)被证明是在重新加权既有能力,而不是扩展它:小采样数下的通过率在涨,大采样数下并没有超过基座模型——模型没有学会新东西,只是把已有的排到了前面。其二,后训练本身损害校准:对齐后的模型比预训练版本可测量地更过度自信。这两个病症的共同名字是:模型不知道自己能力的边界在哪——而这恰恰是失败数据教的东西。
其三,受控证据已经存在:在”错误+修正”配对的数据上微调,曾把 LLaMA-2-70B 的数学成绩推到一时超过 GPT-4;针对一个正在坍缩的多步工具使用训练,过程反思监督把成绩拉起 22 分以上,并在训练分布之外的场景拿到非零分数——那里纯监督微调的基线恰好是零分。
方法有效,证据在手。缺的是对实践的系统记述:各家技术报告里零散的披露,从来没有被放在一起比较过——因为缺少一套”这条管线如何对待失败数据”的共享词汇。
三、怎么查:给失败数据的待遇定级
我们设计了一套生命周期量表,给”训练管线如何对待失败数据”定级,从 L0 到 L4:
- L0 丢弃——失败轨迹直接扔掉(拒绝采样的默认操作);
- L1 影子——失败只作为”被拒绝的那一侧”沉默存在(偏好对数据);
- L2 瞬时——失败作为一次性梯度用掉就丢(RL 环境里);
- L3 组件——失败数据有专门设计的组件在运行;
- L4 一等公民——失败记录像成功记录一样被规模化采集、归因、留存、发布,成为公开方法论的一部分。
外加六个子维度(错误定位、因果归因、反思修正等),判据冻结在编码手册里,每条编码锚定一手来源——你可以不同意我们的判级,可以去查我们的引文。
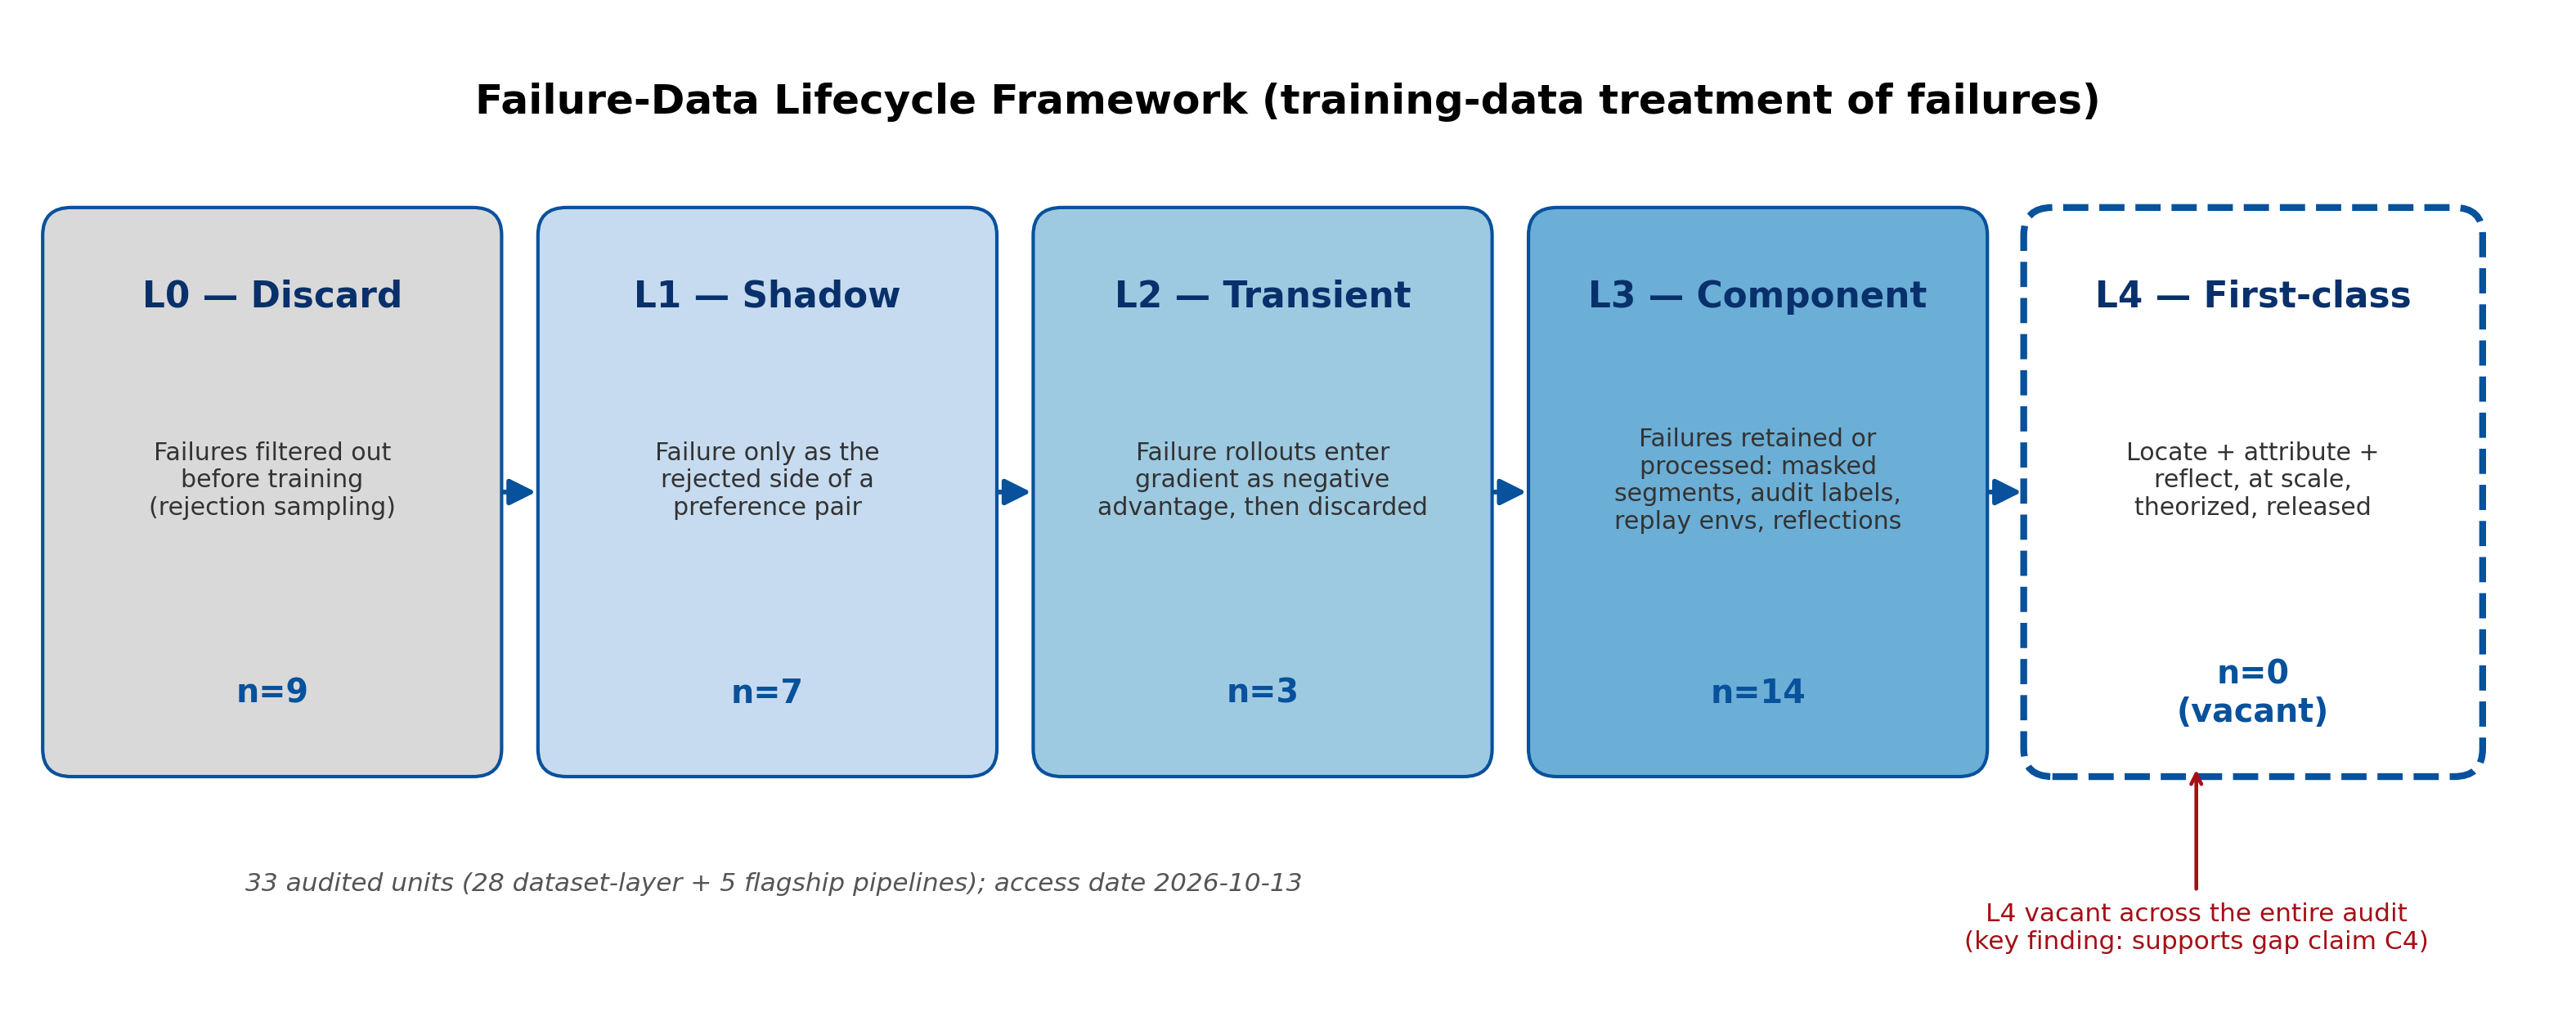
失败数据生命周期(论文原图)。 失败数据在训练管线里的五种待遇,从丢弃到一等公民——本图即编码手册的框架:L0 丢弃(discard)、L1 影子(shadow)、L2 瞬时(transient)、L3 组件(component)、L4 一等公民(first-class)。
审计对象 33 个单元:28 个开源数据集与主流训练配方(2023–25 年),加上 5 条 2026 年旗舰管线的披露,共产出 44 条机制级编码记录。
四、结果一:数据集层,系统性的降格
分层非常干净,干净到刺眼。
全部 7 个监督微调(SFT)单元,无一例外,都是 L0。 拒绝采样式的”做错的扔掉”是 2023–25 年 SFT 数据生产的默认操作——从 Llama 2/3 到各家开源数学数据集,一视同仁。
偏好阶段 6 个单元全部 L1。 偏好对里”被拒绝的那一侧”确实承载着失败——但它从不被单独标注、定位、归因,只是作为对比的阴影存在。
把主流子集单拎出来(SFT+偏好+RL,15 个单元):0 个达到 L3,中位数在 L1。也就是说:主流配方对失败数据的处理,停留在”扔掉”和”当影子”之间。
而所有 L3 单元都在哪?全在学术例外层。 社区显然知道怎么构建富含失败样本的数据集——论文里造得出来——只是不在主流配方里交付。
五、结果二:一处空缺,一次转向
L4 完全空缺:33 个单元,0 个。 没有任何一家以规模化方式同时做到错误标注、因果归因、反思性修正,并作为公开方法论发布。三个要素齐备的,恰好 1 个单元。
但同一份审计也拍到了一次正在发生的代际转变:2026 年的五条旗舰管线里,四条在运行显式的失败数据组件(队列中位数达到 L3)。而且失败信号的载体在迁移——主流时代靠偏好对承载失败,旗舰时代迁往 RL 环境与审计回路(偏好对载体在旗舰机制里:0/14)。
读法:行为已经变了,方法论还没有名字。 行业在工程上开始开采失败,却没有人把它写成可复用的方法论——这次审计补的就是这个坐标。
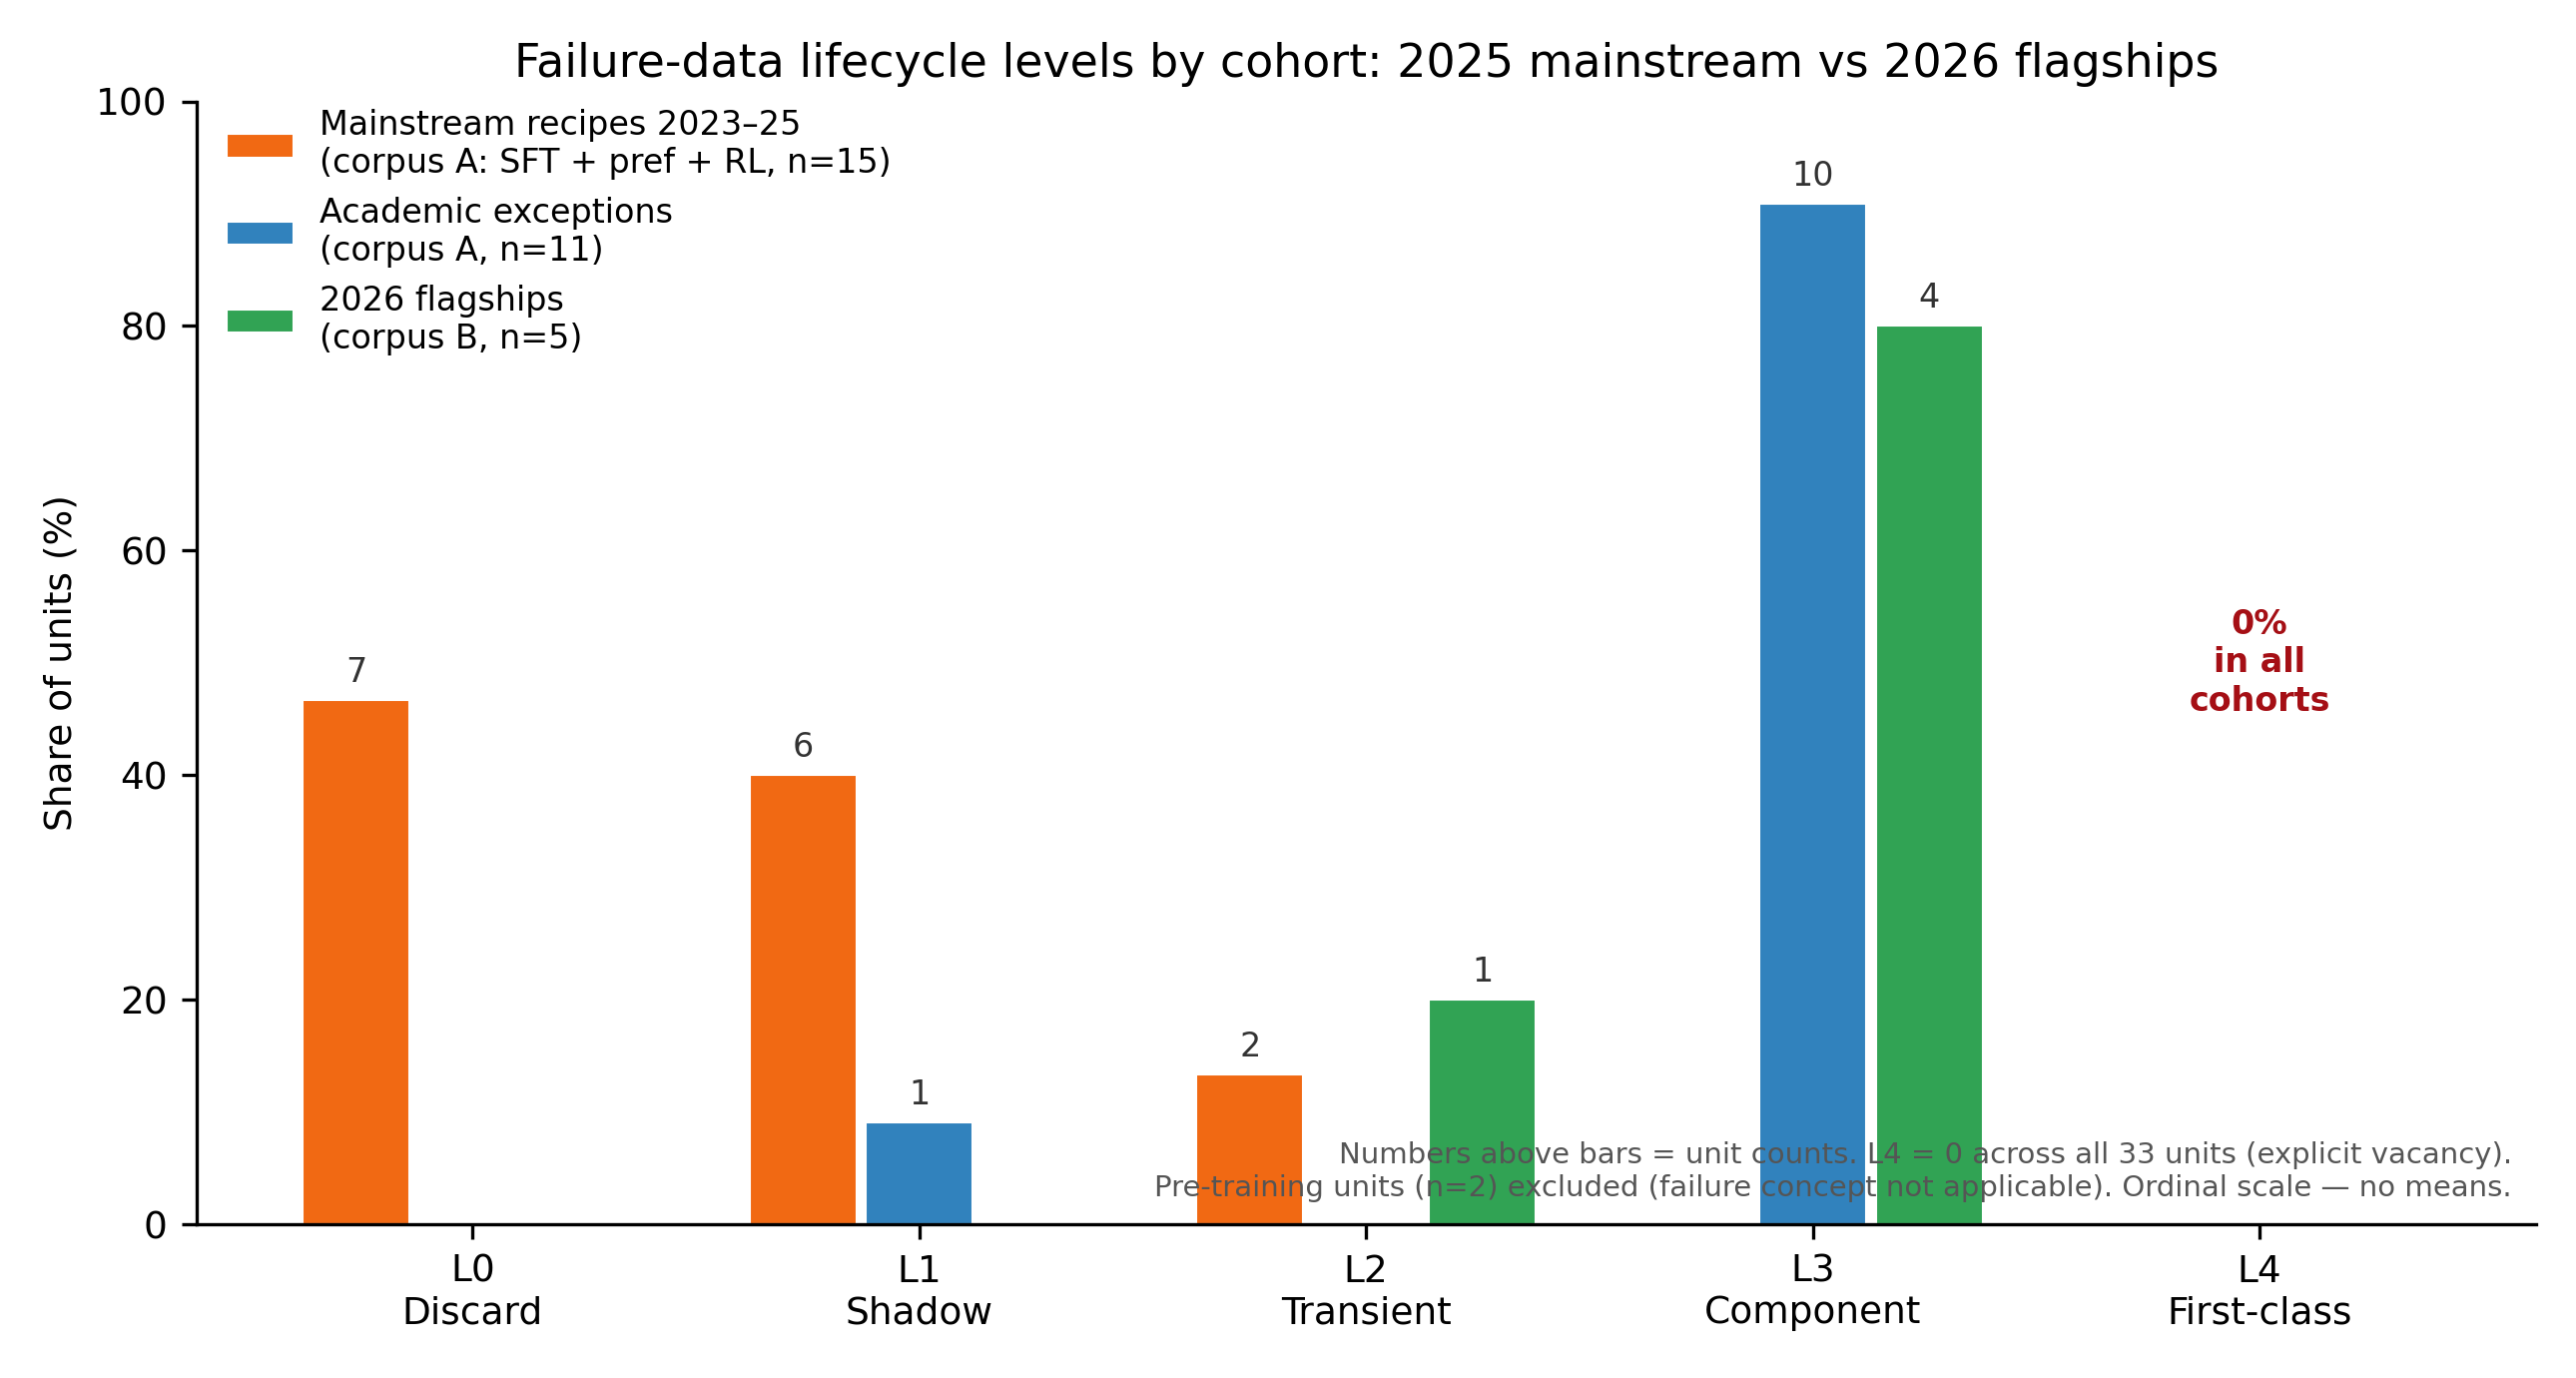
失败数据待遇的三个队列(论文原图)。 横轴为生命周期级别(L0 丢弃 — L4 一等公民),纵轴为单元占比;颜色区分队列:橙 = 2023–25 主流配方,蓝 = 学术例外,绿 = 2026 旗舰。主流堆积在 L0/L1,学术与旗舰顶到 L3;L4 处三个队列全部为零——图上标注 “0% in all cohorts”。
六、路线图:让失败数据成为一等公民
审计顺带画出了厂商地图:五家旗舰,无一集齐全部组件,而开放语料环节全行业空缺。缺的基础设施是具体的:
- 三元数据模式——失败记录作为一等对象,三个必填字段:错误类型(定位到步骤)、根因、更正文本,加溯源信息。这是错题本的数据结构化。
- 采集与标注协议——谁采集(用户、员工、模型自己的 rollout)、按多样性而非数量抽样、标注用的分析器模型必须披露。
- 去毒化清洗——训练前的强制阶段,把假成功(奖励作弊)、环境故障、真正有价值的模型失败三者分开。旗舰已有先例:有的把确认作弊的轨迹奖励归零,有的在记录失败原因后剔除”环境崩溃”的样本——不能教模型相信环境损坏是它自己的错。
- 开放语料与共享协议——目前一家都没有。
七、这块高地的后面
失败数据是一块无人占据的高地——这是审计在披露层面内的结论。而它背后还有更大的图景:失败不是孤立的数据类型,它是人类实践之流中信息量最大的切片。医生怎么误诊又怎么修正,程序员怎么写错又怎么修复——这些错题不在任何档案库里,它们是活的实践的一部分。
那已经是姊妹篇《AGI 人本拟合论》要论证的事:拟合对象不是作品,而是实践。这份审计是那条论证链的实证起点。
成功给方向,失败给精度。 学生懂的道理,模型的训练管线迟早也要懂。