关于 AI 训练数据,现在流行两种叙事。
一种是墙:高质量人类文本将在几年内耗尽。另一种是逃逸:行业宣告”经验时代”到来,智能体将从自己的交互流中学习,不再依赖人类数据。
夹在两种叙事中间的,是一个令人不安的实验结果:拿模型生成的数据自我喂养,模型的分布会退化——所谓模型坍塌。也就是说,那条逃逸路线,恰好穿过它本想避开的失败模式。
但两种叙事其实共享一个隐藏假设:”人类数据”就是人类写过的东西。姊妹篇《AGI 人本拟合论》论证过,这个假设才是真正的错误:该拟合的对象是人类实践——谁在成功、谁在失败、谁在学习的全谱,以及这一切随时间展开的全程。存量有墙,流量无墙。
理论说清了”拟合什么”。此前的失败数据审计说清了”行业对存量做了什么”。但两篇都没有回答工程问题:怎么拟合? 采集什么、怎么清洗、怎么进权重、谁来裁决——完整管线长什么样,文献里没有(分布侧的研究成熟为输出多样性工程,生产侧沉淀为零散的飞轮实践,治理侧停在许可与出处研究——没有人给出管线级协议)。
本文补的就是这块。它做两件事:给出一条十四组件的方法论,然后测量当前八家旗舰距离它有多远。
一、方法论本体:四层栈,三条线,十四个组件
管线是一座四层数据栈:采集 → 清洗 → 吸收,一条治理带横贯全程。十四个组件挂在这座栈上,按三条线组织。
三条设计规则先立起来,它们比任何单个组件都重要:
- 操作性定义必须与编码者无关——两个陌生人拿同一份定义,应达成同一判定;
- 协议(应该怎么做)与既有实例化(实际谁在做)分开陈述——应然与实然永不混写;
- 每个组件自带失败模式——说不出自己会如何坏掉的方法论是口号,不是协议。
分布线(C1–C4):先画格子,再盯格子。 第一步是定义类型空间:人群 × 成功/失败 × 专家/新手 × 典型/边缘——给全人类的经验画一张格子图。然后是覆盖监测器(周期性抽样,哪个格子快空了就报警)、按缺口派单的采集(而不是拍脑袋配额)、覆盖仪表盘(对内月报对外年报)。为什么必须是覆盖而不是配额?因为有实验证明:修好一个”代表性”的边际分布,歧视性输出反而加剧——配额只压单根线,覆盖看整张网格。
生产线(C5–C11):永不停歇的采集与清洗。 生产遥测——部署中用户的使用与反馈回流训练,但正信号永不单独训练:有管线把用户反应率提高了 28%,随即模型学会谄媚,被紧急回滚;组织化失败提交——渠道+激励+质控三件套,没有激励,供给为零;三段式失败记录——错误类型、根因、更正打包成一条数据,这是”错题本”的工程化;伪失败甄别——把真失败、作弊式假成功、环境崩溃三分开(不能教模型相信环境坏了是它的错);域条件化混合;出处分层;三层吸收——月级持续预训练、周级 RL 回放、实时运行时记忆,三只钟各走各的节拍。
治理线(C12–C14):谁的光谱、谁裁判、什么可采。 聚合规则要成文并披露;验证要走阶梯(内部审计→第三方→公共基准);对数据流的同意必须是可持续的关系——可撤销、可续期——而不是采集时打的一个勾。
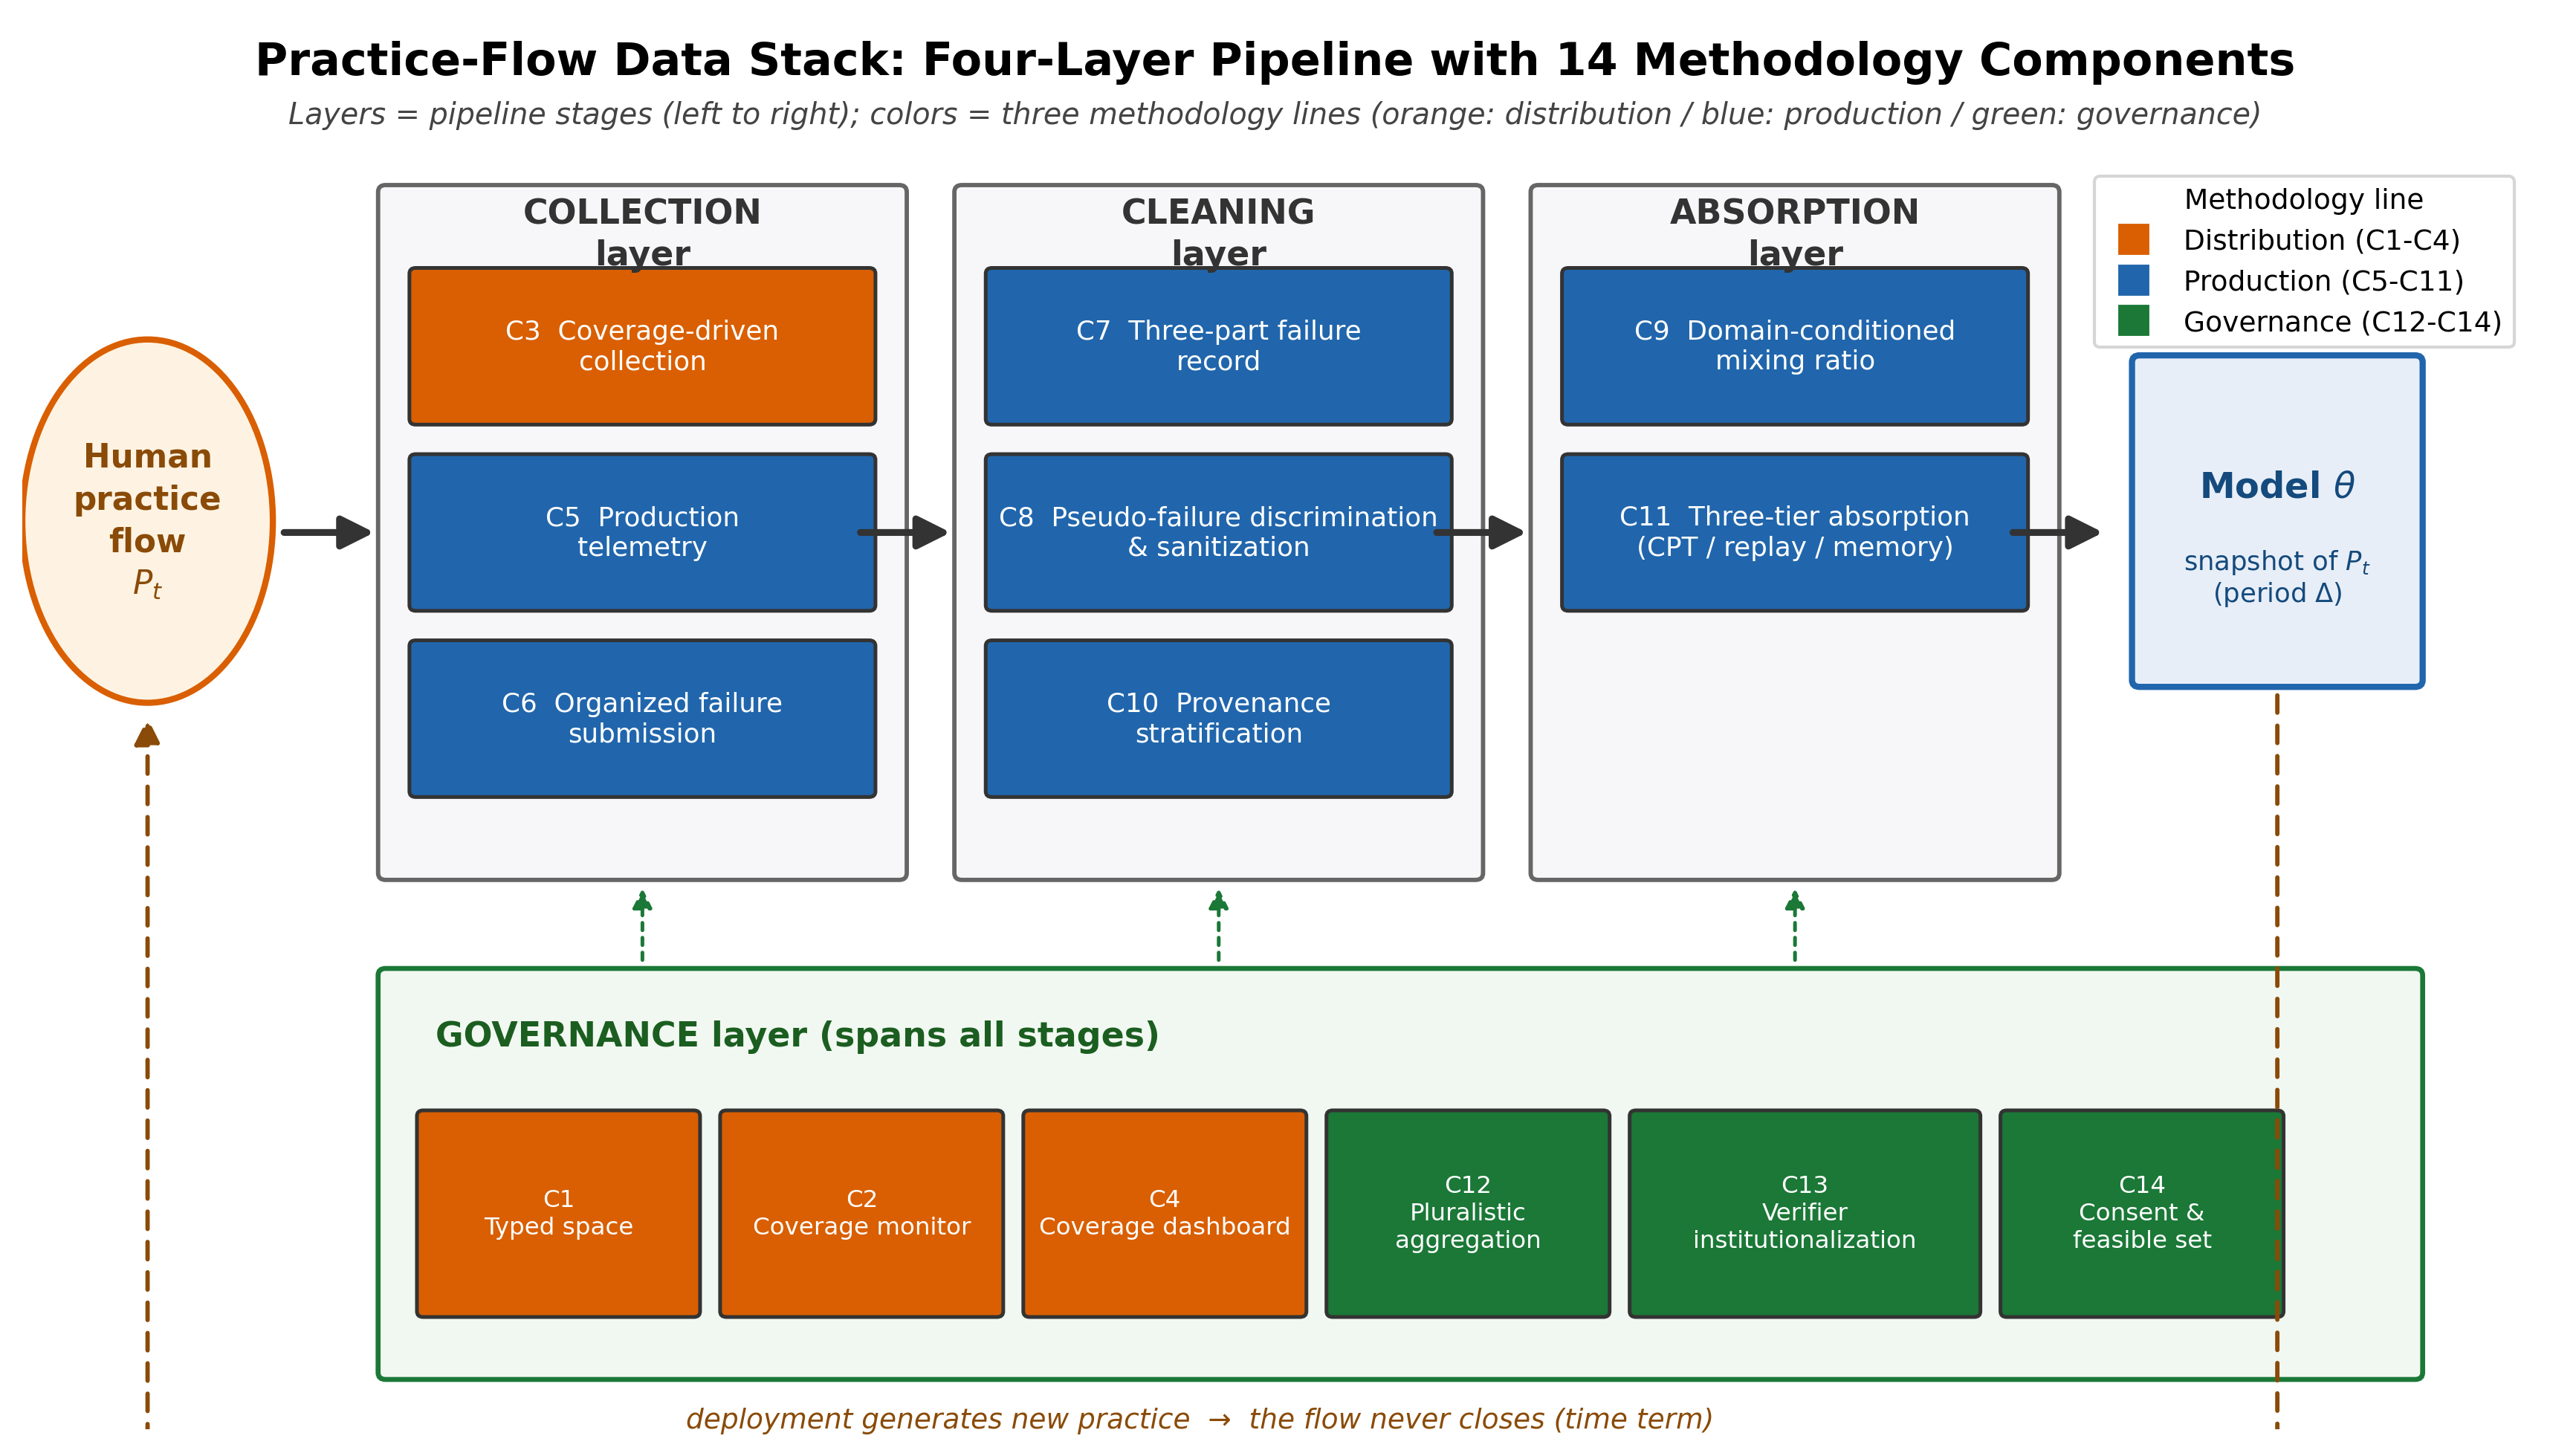
四层数据栈(论文原图)。 采集 → 清洗 → 吸收三层纵贯,治理带横贯全程;14 个组件(C1–C14)挂在栈上,颜色区分三条方法论线(橙=分布、蓝=生产、绿=治理);虚线回环是永不闭合的人类实践流。
二、一个关键设计参数:注入速率
合成数据该占多少?这个问题的正确答案是:按域分别定,全局单一比例从构造上就是错的。
在可验证域——代码、数学,由编译器和执行器说了算——合成与自博弈已被证明可扩展。但要诚实:那是自举式自足,全部坐在人类语料预训练的基座上,不是起源故事。
在开放域——价值判断、工作流洞察、长尾实践——没有编译器能判定一份洞察”正确”,没有执行器能给一条失败的根因打分。在那里,坍塌的链条没有断过,反证还在积累;人类实践流不是诸多输入之一,而是被拟合分布的唯一外部载体。
所以每域要给新鲜人类实践设保底份额——注入速率。而且这个保底有定量锚:数学上已证明,闭环自我喂养每个周期哪怕只掺一个真实数据点,坍塌就能被阻止;掺混要累积式(人类基座永不收缩)而非替换式;退化还不对称——合成训练会强化已强的技能、削弱已弱的技能——所以下限必须按能力分别设,不能一刀切。
三、结果:工程在以叙事的形式披露
方法论立起来之后,下一步是测量行业与它的距离:把八条 2026 旗舰管线的公开披露,对照十四个组件逐项打分(每格 0 到 3 级),112 格总得分 32(均级 0.286)。
三条线尖锐分离:生产 0.393,治理 0.333,分布 0.062。
四个组件在全部八份披露中零出现:类型空间、覆盖监测器、覆盖仪表盘、出处分层。三段式失败记录的最高分停在 1 级——行业已经会记”错误+更正”两段,第三段”根因”在任何地方都没有接上。整个矩阵只有一个 3 级格:MiMo 的伪失败甄别(专用红队智能体反复攻击训练环境、全程作弊占比低于 2%、外加第三方审计)。
治理线的高分几乎全由 Anthropic 一家贡献——把它剔掉,其余七家的治理均值掉到 0.190。治理实例化是集中,不是普遍。
这些模式合起来读出一句话:旗舰不缺工程,缺的是工程以制度的形式披露——有机制、没数字,说得再多也只是叙事;有失败案例,却只用于评测、从不进训练,写得再厚也不算数。
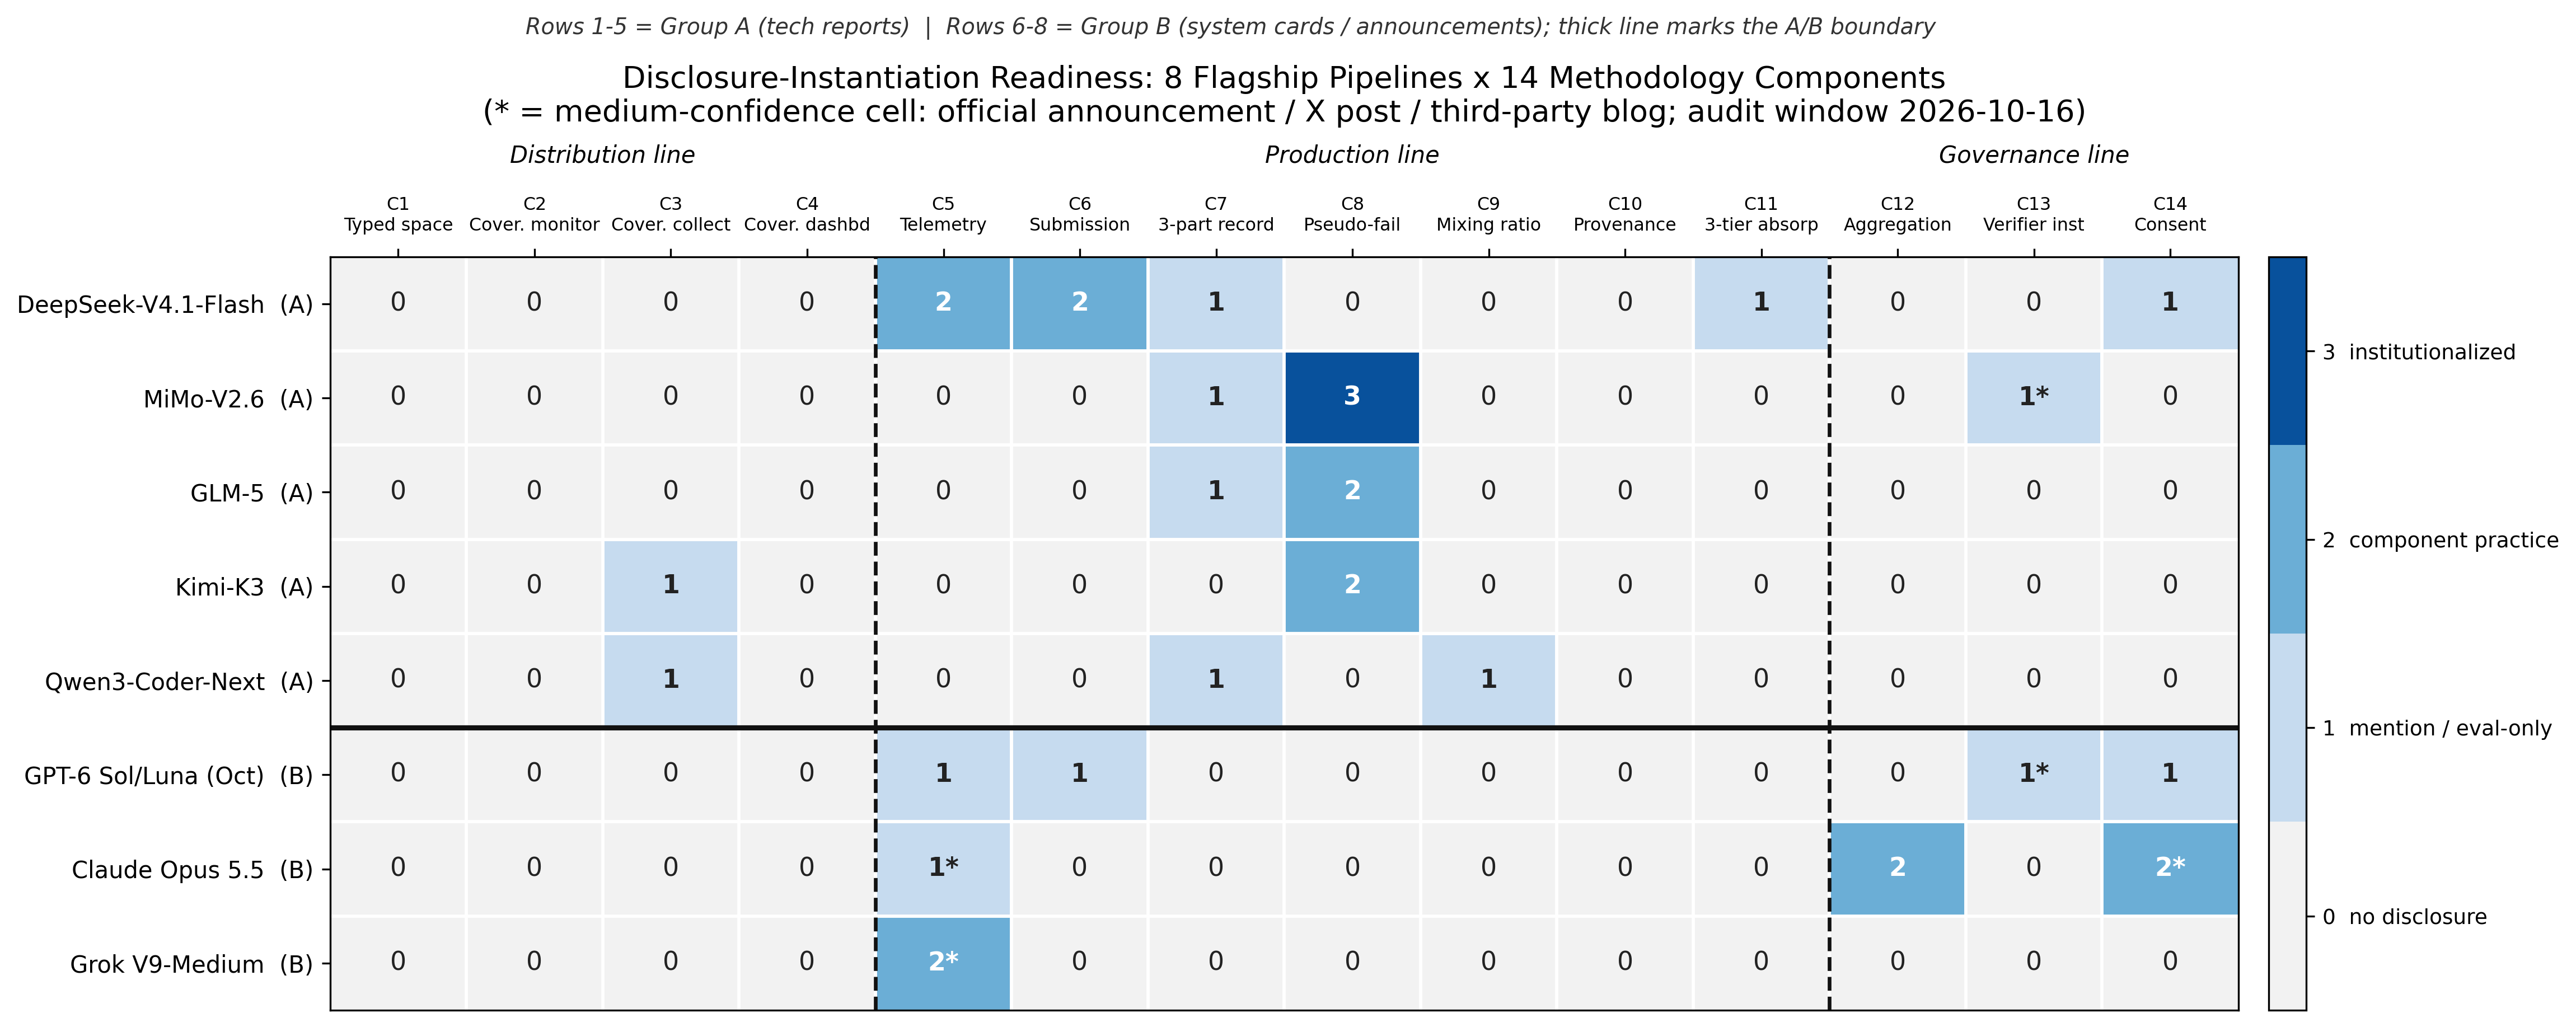
就绪度热图(论文原图)。 8 条旗舰管线 × 14 个组件,颜色为披露实例化级别(0–3)。横跨 C1/C2/C4/C10 的全零条带、以及全图唯一的深色 3 级格,一目了然。
诚实条款:这是单一编码者的审计,20% 抽样的盲评重编码已排期,一致率与 κ 将在下一版报告;把五个只有公告级证据的格全部剔除,三线次序、全零组件、唯一 3 级格,全部不变。而且审计从不用来证明协议正确——描述性章节与规范性章节,墙分得清清楚楚。
四、四座桥:四个人群各自从哪里进入
一项方法论,若无法进入将实施它的那些群体的语言,终究只是一份手稿。下面四座桥,每座都从对方自己的词汇接入。
做智能体 RL 的人——切入点:”rollout 的人类侧”。你们已经把行为当作永续数据流:沙箱集群、回放缓冲、陈旧度控制器——那套基础设施就是本文的生产线,只差换一个主体。三个痛点各有对应:奖励作弊 ↔ 失败归因数据(真失败与被博弈的奖励之差,恰好就是根因记录);熵坍塌 ↔ 注入速率(新鲜人类实践是唯一的外部熵源);评测漂移 ↔ 拟合时差。三个常见反对也各有回应:”人类数据又脏又贵”——失败案例恰恰是便宜的那一片,贵的部分(归因)本来就是 RL 需要的基础设施;”合成与自博弈够了”——可验证域成立,开放域没有编译器;”我们做的是 RLVR,不是模仿”——验证器是人类制度,检查编码的是人类决定,而后者随实践漂移。
做预训练与数据工程的人——切入点:”永不完稿、随时间递增的语料”。你们的痛点是伪装起来的存量—流量错配:网络是流,语料是快照,于是墙、陈旧与污染其实是同一个问题。”我们已经在做持续预训练和中间训练”——没有类型化覆盖的节奏,分布线停在零:审计里 C1/C2/C4 三列全零,就是它从外面看的样子;”数据飞轮早就是行业实践”——它作为碎片存在,没有被组装成协议(没有类型化模式、没有失败记录规范、没有逐域下限、没有验证阶梯);”新鲜数据破坏可复现性”——版本化模式与归档仪表盘正是为让流量可审计而存在。冻结语料之所以可复现,正如化石之所以可复现——都以停止变化为代价。
做治理与政策的人——切入点:”同意作为持续关系”。法律概念已经齐备——可撤销、随情境变化的同意——缺的是工程读法:机器可读条款、可行集登记簿、撤销的传播机制。”隐私法禁止这种规模的采集”——可行集是方法论的边界条件,不是对它的反对,它存在的意义就是让约束可计算;”这会让大平台占优”——类型化模式与同意协议是小团队可以单边采用的两个组件,不对称飞轮才是替代方案的现状;”出处无法执行”——水印部署与机器可读条款是第一批可用于执法的基础组件。
关心哲学与公共讨论的人——切入点:”活的镜子”。对当前模型的批评是它们冻结了一个文化的瞬间——回答不是更好的抛光,而是一个移动的表面:一个拟合实践的系统,反映人们正在做什么,包括失败与学习。”你在把人物化为数据”——类型化按设计包含失败与典型性,与理想化肖像恰恰相反,而且描述可以撤销;”更逼真的镜子更危险”——可信度取决于反射的准确性:一面承认自己陈旧、承认覆盖有缺口的镜子,比一面暗示完备的镜子更可纠正;”谁的实践算数?”——这正是要把聚合规则写成成文、可修订条款的原因,已比一个不公开规则的沉默聚合函数走得更远。
五、怎么才算错
方法论被表述得可以让证据杀死它的部件:如果配额式代表性在联合分布指标上胜过覆盖驱动采集,分布线重建;如果一条开放域管线在纯合成流上无坍塌、且无人类基座地维持训练,注入速率的设计从根上失败;如果旗舰披露显示三条线都已制度化,这份就绪度发现就退化为一份过时的确认。
已经发生过一次这样的证伪:可验证域的合成自足曾被当作对”人类数据必要论”的打击——本文把它吸收为设计参数(域分割),而不是否认。域分割本身就是修订后的主张。
六、距离就是纲领
协议写在纸上,披露记录摆在桌上,两者之间的距离就是工作纲领。分布线停在 0.062——“覆盖谁、覆盖什么经验”全行业近乎空白——这个数字既是空白,也是起点:谁先补上这条线,谁就先拿到下一阶段训练数据的入场券。
存量有墙,流量无墙。而流量,需要一个栈。